Crear cuenta
Examen oficial · A1Test

Prueba de conocimientos básicos (test) - Personal experto en Inteligencia Artificial y Ciencia de Datos, convocatoria 08/2025, perfil Ciencia de Datos (Banco de España)

Técnico/a Superior de Sistemas de InformaciónTurno libre

Banco de España

12 de julio de 2025 · 17:30 hLugar: Facultad de Derecho de la Universidad Autónoma de Madrid (Campus de Cantoblanco, C/ Kelsen, 1, 28049 Madrid)50 preguntas

Cuestionario y respuestas contrastados con fuentes oficiales

Modalidad de la prueba

Test

Carácter
Teórica
Preguntas
50
Imágenes
Incluye imágenes del documento oficial
Corrección automática
Sí
Respuestas correctas
Plantilla definitiva

Contenido del examen

50 preguntas · 7 materias

  • Informática y TIC 24 preguntas · 48 %
  • Inteligencia artificial y datos 11 preguntas · 22 %
  • Programación y desarrollo 7 preguntas · 14 %
  • Bases de datos y SQL 3 preguntas · 6 %
  • Sistemas operativos 3 preguntas · 6 %
  • Transparencia y Buen Gobierno (Ley 19/2013) 1 pregunta · 2 %
  • Unión Europea 1 pregunta · 2 %

Sistema de puntuación

  • +3 correcta
  • −1 incorrecta
  • 0 en blanco

Según la documentación oficial del proceso.

Ver criterio completo

Base 7.1.2: cada respuesta correcta vale 1 punto, en blanco 0 y la incorrecta resta 0,33 puntos (en tercios: +3/−1).

Consultar las bases (abre en una pestaña nueva)

Realiza el examen

0 de 50 respondidas

Pregunta 1 de 50 Informática y TIC Considere la siguiente ecuación e indique a qué distribución de probabilidad conocida corresponde, así como sus parámetros:
Fórmula: (1/√(8π)) · e^(−(x−1)²/8)
Pregunta 2 de 50 Informática y TIC Al realizar una descomposición en autovectores de la matriz de covarianza de los datos observa que existe un autovalor cercano a 0. ¿Qué implicaciones tiene esto?
Pregunta 3 de 50 Informática y TIC Se plantea un problema de clasificación binaria en el que la relación de clases sigue una proporción de 99% para la clase mayoritaria y 1% para la clase minoritaria. A la hora de diseñar un estudio de diferentes modelos supervisados de clasificación y teniendo en cuenta que ambas clases son importantes para el problema a resolver, ¿qué métrica sería más adecuada para validar qué modelo produce mejores resultados?:
Pregunta 4 de 50 Informática y TIC Está usted realizando ingeniería de características para un problema de clasificación de documentos, y ha decidido emplear un método del tipo bolsa de palabras (bag of words) para transformar los textos a vectores. Suponiendo que ha configurado este método para contar bigramas de palabras, ¿cuál de los siguientes vectores sería una representación posible del texto “El reloj de la pared de la cocina no funciona”?
Pregunta 5 de 50 Transparencia y Buen Gobierno (Ley 19/2013) Participa usted en un proyecto donde se plantea instalar en una plaza pública una serie de cámaras que, mediante algoritmos de visión artificial, identifiquen en tiempo real a las personas que cometan actividades delictivas, como pudiera ser la realización de pintadas ilegales. Bajo el reglamento europeo de la IA, ¿en qué nivel de riesgo debería catalogarse este tipo de sistema?
Pregunta 6 de 50 Informática y TIC Indique el resultado que se generaría al ejecutar el siguiente programa en R:
Código R:
ff <- function(n) {
  f <- c()
  i <- 2
  while (i < n) {
    if (n %% i == 0) {
      f <- c(f, i)
      n <- n / i
    }
    else i <- i + 1
  }
  if (n > 2) f <- c(f, n)
  return(f)
}
print(ff(70))
Pregunta 7 de 50 Bases de datos y SQL Analice la siguiente estructura de base de datos: ¿Cuál sería la consulta SQL adecuada para obtener los nombres de los 10 clientes que han realizado pagos por mayor importe total de todas sus compras en el comercio “Tienda ABC” durante el mes de marzo de 2025?
Diagrama entidad-relación con cuatro tablas. Clientes: id_cliente (integer, PK), nombre varchar(100), email varchar(150), fecha_registro timestamp. Cuentas: id_cuenta (integer, PK), id_cliente (integer, FK→Clientes), numero_cuenta varchar(20), tipo_cuenta enum, saldo decimal(15,2). Comercios: id_comercio (integer, PK), nombre varchar(150), categoria varchar(100), ubicacion text. Pagos: id_pago (integer, PK), id_cuenta (integer, FK→Cuentas), id_comercio (integer, FK→Comercios), monto decimal(10,2), fecha_pago timestamp, metodo_pago enum.
a)
SELECT c.nombre, SUM(p.monto) AS tgas
FROM Pagos p
JOIN Cuentas cu ON p.id_cuenta = cu.id_cuenta
JOIN Clientes c ON cu.id_cliente = c.id_cliente
JOIN Comercios co ON p.id_comercio = co.id_comercio
WHERE co.nombre = 'Tienda ABC'
AND strftime('%Y-%m', c.fecha_registro) = '2025-03'
GROUP BY c.nombre
ORDER BY tgas DESC
LIMIT 10;
b)
SELECT c.nombre, SUM(p.monto) AS total_gastado
FROM Pagos p
JOIN Cuentas cu ON p.id_cuenta = cu.id_cuenta
JOIN Clientes c ON cu.id_cliente = c.id_cliente
JOIN Comercios co ON p.id_comercio = co.id_comercio
WHERE co.nombre = 'Tienda ABC'
AND strftime('%Y-%m', p.fecha_pago) = '2025-03'
GROUP BY c.id_cliente
ORDER BY p.monto DESC
LIMIT 10;
c)
SELECT c.nombre, MAX(p.monto) AS total_gastado
FROM Pagos p
JOIN Cuentas cu ON p.id_cuenta = cu.id_cuenta
JOIN Clientes c ON cu.id_cliente = c.id_cliente
JOIN Comercios co ON p.id_comercio = co.id_comercio
WHERE co.nombre = 'Tienda ABC'
AND strftime('%Y-%m', p.fecha_pago) = '2025-03'
GROUP BY c.id_cliente
ORDER BY total_gastado DESC
LIMIT 10;
d)
SELECT c.nombre, SUM(p.monto) AS tgas
FROM Pagos p
JOIN Cuentas cu ON p.id_cuenta = cu.id_cuenta
JOIN Clientes c ON cu.id_cliente = c.id_cliente
JOIN Comercios co ON p.id_comercio = co.id_comercio
WHERE co.nombre = 'Tienda ABC'
AND strftime('%Y-%m', p.fecha_pago) = '2025-03'
GROUP BY c.id_cliente
ORDER BY tgas DESC
LIMIT 10;
Pregunta 8 de 50 · N.º original 9 Programación y desarrollo Se dispone a realizar un análisis sobre un fichero en formato CSV, del cual se muestran a continuación sus primeras filas: Debe encontrar la puntuación media que los usuarios han otorgado a cada tipo de restaurante en cada ciudad. Para evitar utilizar datos antiguos, deberá filtrar aquellos para los que la puntuación se haya asignado antes del 1 de febrero de 2024. Así mismo, no deberá tener en cuenta en sus cálculos aquellos restaurantes que hayan recibido menos de 5 críticas. Para todo ello ha elaborado el siguiente script en Python: Indiqué qué código debería introducirse en las líneas faltantes del script:
Restaurant,City,User,Score,VisitDate,Type
La Trattoria,New York,Alice,4.5,2024-03-10,Italian
Sushi Zen,Los Angeles,Bob,3.8,2024-02-25,Japanese
El Taco Loco,Houston,Charlie,5.0,2024-03-15,Mexican
Steakhouse 101,Chicago,David,4.2,2024-01-20,Steakhouse
Vegan Delight,San Francisco,Emily,3.5,2024-02-10,Vegan
Pasta Paradise,Miami,Frank,4.7,2024-03-05,Italian
BBQ Central,Dallas,Grace,4.0,2024-01-28,Barbecue
Curry House,Seattle,Henry,3.9,2024-02-18,Indian
Ocean Bites,Boston,Irene,4.8,2024-03-12,Seafood
Burger Haven,Denver,Jack,3.6,2024-01-30,American
import pandas as pd
df = pd.read_csv("reviews.csv")
df["VisitDate"] = pd.to_datetime(df["VisitDate"])
df = df[df["VisitDate"] >= "2024-02-01"]
restaurant_counts = df["Restaurant"].value_counts()
[FALTANTE]
a)
df = df[df["Restaurant"].isin(restaurant_counts[restaurant_counts > 5].index)]
df.groupby(["City", "Type"]).mean()["Score"]
b)
df = df[df.isin(restaurant_counts[restaurant_counts >= 5])]
df.groupby(["Type", "City"]).mean()["Score"]
c)
df = df[df.isin(restaurant_counts[restaurant_counts > 5].index)]
df.groupby(["Type", "City"])["Score"].mean()
d)
df = df[df["Restaurant"].isin(restaurant_counts[restaurant_counts >= 5].index)]
df.groupby(["City", "Type"])["Score"].mean()
Pregunta 9 de 50 · N.º original 10 Bases de datos y SQL Se le plantea el diseño de una aplicación de analítica que necesita poder ejecutar consultas sobre una gran cantidad de información de compras realizadas por usuarios en una web de comercio online, con el fin de detectar redes de clientes que compran los mismos productos, y así hacer poder recomendaciones del tipo “otros clientes como tú también compraron…”. El sistema en producción emplea una base de datos de tipo SQL para su operativa transaccional habitual; sin embargo, es necesario diseñar un sistema paralelo que permita realizar estas analíticas, para no entorpecer la actividad de producción del sistema actual. Teniendo en cuenta estos requisitos, ¿cuál de las siguientes tecnologías de base de datos sería más adecuada para este fin?
Pregunta 10 de 50 · N.º original 11 Informática y TIC Se encuentra usted afrontando un problema de predicción de series temporales con resolución diaria. Al visualizar la serie histórica obtiene la siguiente gráfica: Indique cuál sería la forma más adecuada de preprocesar los valores de esta serie antes de usarlos como entrada para un modelo predictivo:
Gráfico de serie temporal diaria (eje X: Year, de 2010-01-01 a 2020-01-01; eje Y: Value, de 0 a ~180) con tendencia creciente aproximadamente lineal y un patrón estacional anual (oscilación que se repite cada año), con algo de ruido.
Pregunta 11 de 50 · N.º original 12 Informática y TIC Analice el siguiente código, para el que ya se han realizado los imports necesarios y se ha creado un contexto de Spark en la variable sc: Considere también los siguientes ficheros de datos: “stopwords.txt” en un la el a de “doc.txt” En un lugar de la Mancha, de cuyo nombre no quiero acordarme En nombre de todos los presentes en este lugar ¿Cuál sería el resultado de la ejecución del programa?
Código PySpark:
stopwords = sc.textFile("stopwords.txt").map(lambda x: x.strip().lower()).collect()
doc_rdd = sc.textFile("doc.txt")

words = doc_rdd \
    .flatMap(lambda line: line.lower().split()) \
    .filter(lambda word: word and word not in stopwords)

word_counts = words.map(lambda word: (word, 1)) \
                   .reduceByKey(lambda a, b: a + b) \
                   .sortBy(lambda pair: -pair[1])

print(word_counts.collect())
Opciones de respuesta:
a) [('lugar', 2), ('nombre', 2), ('no', 1), ('todos', 1), ('los', 1), ('presentes', 1), ('mancha', 1), ('cuyo', 1), ('quiero', 1), ('acordarme', 1), ('este', 1)]
b) [('lugar', 2), ('nombre', 2), ('no', 1), ('todos', 1), ('los', 1), ('presentes', 1), ('Mancha', 1), ('cuyo', 1), ('quiero', 1), ('acordarme', 1), ('este', 1)]
c) [('en', 3), ('de', 3), ('lugar', 2), ('nombre', 2), ('un', 1), ('la', 1), ('no', 1), ('todos', 1), ('los', 1), ('presentes', 1), ('mancha', 1), ('cuyo', 1), ('quiero', 1), ('acordarme', 1), ('este', 1)]
d) [('lugar', 2), ('nombre', 2), ('todos', 1), ('los', 1), ('presentes', 1), ('mancha', 1), ('cuyo', 1), ('quiero', 1), ('acordarme', 1), ('este', 1)]
Pregunta 12 de 50 · N.º original 14 Programación y desarrollo Analice el siguiente código en Python, teniendo en cuenta que ya cuenta con un conjunto de datos cargado en las variables “X” e “y”: Indique en qué línea se ha producido un error metodológico:
01. X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
02. scaler = StandardScaler()
03. X_train_scaled = scaler.fit_transform(X_train)
04. X_test_scaled = scaler.fit_transform(X_test)
05. lr = LogisticRegression()
06. param_grid = {'C': [0.1, 1.0, 10.0]}
07.
08. grid_search = GridSearchCV(lr, param_grid)
09. grid_search.fit(X_train_scaled, y_train)
10.
11. y_pred = grid_search.predict(X_test_scaled)
12. print("Accuracy:", accuracy_score(y_test, y_pred))
13. print("\nClassification Report:\n", classification_report(y_test, y_pred))
Pregunta 13 de 50 · N.º original 15 Programación y desarrollo Para una aplicación de aprendizaje supervisado se ha diseñado un modelo de clasificación cuya función de pérdida toma la siguiente forma: donde x es una lista con cada uno de los vectores de variables explicativas de los datos de entrenamiento, y es un vector con las correspondientes etiquetas de clasificación (0 o 1), y ||w||₂² denota el cuadrado de la norma L2 o euclídea del vector w. Suponiendo que se va a realizar el aprendizaje de este modelo mediante un algoritmo de descenso por gradiente con momento, denotando la tasa de aprendizaje como δ y el factor de momento como μ, ¿cuál de las siguientes opciones representa fielmente el método de actualización del vector de parámetros w del modelo?
f(x,y) = 1/2 Σ_{i=1}^{N} ReLU(y_i (w · x_i)) + λ‖w‖₂²
a) ∇^(t) = Σ_{i=1}^{N} y_i x_i + 2λ w^(t); m^(t+1) = μ m^(t) − δ ∇^(t); w^(t+1) = w^(t) + m^(t+1)
b) ∇^(t) = Σ_{i=1}^{N} y_i x_i + 2λ w^(t); m^(t+1) = δ m^(t) − μ ∇^(t); w^(t+1) = w^(t) − m^(t+1)
c) ∇^(t) = Σ_{i=1, y_i(w x_i)>0}^{N} y_i x_i + 2λ w^(t); m^(t+1) = μ m^(t) − δ ∇^(t); w^(t+1) = w^(t) + m^(t+1)
d) ∇^(t) = Σ_{i=1, y_i(w x_i)>0}^{N} y_i x_i + 2λ w^(t); m^(t+1) = δ m^(t) − μ ∇^(t); w^(t+1) = w^(t) − m^(t+1)
Pregunta 14 de 50 · N.º original 16 Programación y desarrollo Está trabajando en un análisis no supervisado de datos, para el que espera encontrar una serie de clusters bien diferenciados. Observa que al realizar proyecciones de baja dimensión de los datos aparecen estructuras como las siguientes: Teniendo en cuenta esta información, ¿qué algoritmo de clustering sería más adecuado?
Proyección 2D de puntos negros que forman estructuras no convexas: un arco/media luna en la parte superior, una forma de «T» o flecha a la izquierda y una forma de «L» invertida/gancho a la derecha; clusters de forma irregular, no globulares.
Pregunta 15 de 50 · N.º original 17 Sistemas operativos Se han entrenado 3 modelos de clasificación supervisada sobre el mismo conjunto de datos, obteniendo las siguientes visualizaciones de sus fronteras de decisión: Indique, de entre las siguientes hipótesis, cuál de ellas es la más plausible sobre los modelos empleados para generar estas fronteras:
Tres paneles con fronteras de decisión sobre los mismos puntos (rojos y azules): 1) frontera lineal suave con degradado azul-blanco-rojo; 2) regiones rectangulares alineadas con los ejes (bloques azul/rojo); 3) regiones curvas y localizadas en forma de manchas alrededor de grupos de puntos.
Pregunta 16 de 50 · N.º original 18 Informática y TIC Al trabajar con un conjunto de datos del sector financiero descubre que existen valores NA en las variables “Nacionalidad” y “Tipo de cliente”. Al indagar por el origen de estos valores le informan que se marcan con NA aquellas nacionalidades que no se han recogido durante el onboarding de los clientes, mientras que los NA en el tipo de cliente se emplean para marcar aquellos clientes de tipos no recogidos en los datos. ¿Cuál sería la forma más adecuada de tratar estas dos variables?
Pregunta 17 de 50 · N.º original 19 Informática y TIC Tras entrenar un modelo de regresión lineal sobre un gran conjunto de datos de entrenamiento, se realiza un análisis de errores en un conjunto de test que se ha obtenido un año después en el proceso de recogida de datos, y se observa que el modelo tiene baja varianza pero alto sesgo, a pesar de que sobre el conjunto de entrenamiento obtenía buenos resultados. Suponiendo que la selección de las muestras de entrenamiento y de test se ha realizado correctamente, ¿cuál de las siguientes explicaciones de la situación podría ser válida?
Pregunta 18 de 50 · N.º original 20 Inteligencia artificial y datos Se encuentra usted involucrado en un proyecto de ciencia de datos donde se pretende modelar el tiempo que un cliente mantiene contratado un servicio de streaming de películas. A lo largo del proyecto se han realizado dos campañas de recogida de datos, en momentos del tiempo diferentes, y necesita garantizar que en ambos periodos el tiempo de permanencia de los clientes sigue una distribución similar. ¿Qué test estadístico podría utilizar?
Pregunta 19 de 50 · N.º original 21 Informática y TIC Analice la siguiente matriz de correlaciones: Suponiendo que va a construir un modelo que prediga el target y que solo puede seleccionar 4 variables explicativas, ¿cuál sería la mejor selección?
Mapa de calor de la matriz de correlaciones de var1…var11 y target (escala de −1 a 1). var1, var2 y var3 tienen correlación ~1 entre sí; var10, var11 y target tienen correlación ~1 entre sí; var4 tiene correlación positiva leve con var10, var11 y target; var5 y var6 correlación positiva leve entre sí; var8 correlación negativa leve con var1–var3 y var6; el resto, correlaciones cercanas a 0.
Pregunta 20 de 50 · N.º original 22 Informática y TIC El siguiente código incompleto en R realiza un trabajo de modelización sobre un conjunto de datos, asumiendo que ya se han importado todas las librerías necesarias y los datos ya se encuentran disponibles en train_data y test_data: Indique cuál es la opción más adecuada para la línea de código faltante:
Código R:
modelo_rf <- ranger(formula = target ~ ., data = train_data, num.trees = 500)
[CÓDIGO FALTANTE]
results <- accuracy_vec(truth = test_data$target, estimate = preds)
print(results)
Pregunta 21 de 50 · N.º original 23 Informática y TIC Se le presenta el fichero de datos “ventas.csv”, del cual se muestran las 10 primeras filas: Teniendo en cuenta que la variable objetivo “ventas” muestra un comportamiento estacional a varias escalas temporales, ¿qué proceso de ingeniería de características sería más útil?
datetime,mes,dia_del_mes,hora_del_dia,temperatura,humedad,evento,ventas
2023-01-01 00:00:00,1,1,0,28.82,42.38,soleado,13
2023-01-01 01:00:00,1,1,1,22.0,39.65,tormenta,20
2023-01-01 02:00:00,1,1,2,24.89,84.27,lluvia,23
2023-01-01 03:00:00,1,1,3,31.2,47.22,nublado,26
2023-01-01 04:00:00,1,1,4,29.34,40.77,tormenta,22
2023-01-01 05:00:00,1,1,5,15.11,90.0,nublado,21
2023-01-01 06:00:00,1,1,6,24.75,48.55,tormenta,22
2023-01-01 07:00:00,1,1,7,19.24,37.48,soleado,26
2023-01-01 08:00:00,1,1,8,19.48,57.71,tormenta,17
Pregunta 22 de 50 · N.º original 24 Informática y TIC Debe implementar en R una función “count_duplicates” que devuelva cuántos caracteres diferentes aparecen más de 1 vez en una cadena de entrada, sin distinción entre mayúsculas y minúsculas. Por ejemplo: ¿Cuál de las siguientes implementaciones sería correcta?
count_duplicates("abcde") → 0
count_duplicates("aabbcde") → 2
count_duplicates("aaAbBcde") → 2
a)
count_duplicates <- function(text) {
  text <- tolower(text)
  seen <- character()
  duplicates <- character()
  for (char in strsplit(text, "")[[1]]) {
    if (char %in% seen) {
      duplicates <- c(duplicates, char)
    } else {
      seen <- c(seen, char)
    }
  }
  return(length(duplicates))
}
b)
count_duplicates <- function(text) {
  chars <- unlist(strsplit(text, split = ""))
  chars <- tolower(chars)
  freq_table <- table(chars)
  duplicate_count <- sum(freq_table > 2)
  return(duplicate_count)
}
c)
count_duplicates <- function(text) {
  chars <- unlist(strsplit(text, split = ""))
  chars <- tolower(chars)
  duplicate_count <- sum(chars > 1)
  return(duplicate_count)
}
d)
count_duplicates <- function(text) {
  text <- tolower(text)
  chars <- strsplit(text, split = "")
  freq_table <- table(chars)
  duplicate_count <- sum(freq_table > 1)
  return(duplicate_count)
}
Pregunta 23 de 50 · N.º original 25 Inteligencia artificial y datos Se necesita construir un modelo de aprendizaje automático que sea capaz de identificar el idioma en el que está escrito un texto, entre los siguientes idiomas: español, inglés, portugués, ruso, griego, chino, árabe y japonés. ¿Cuál de las siguientes aproximaciones sería más práctica en términos de acierto y uso de recursos computacionales?
Pregunta 24 de 50 · N.º original 26 Informática y TIC Tras entrenar un modelo de regresión lineal sobre un gran conjunto de datos de entrenamiento se ha realizado el siguiente análisis de sus errores, tanto sobre el conjunto de entrenamiento original como sobre un conjunto de test recogido un año después. ¿Cuál de las siguientes afirmaciones sería una explicación factible de la situación?
Gráfico «Residuos del modelo en entrenamiento y test» (eje X: X, de 0 a 10; eje Y: Error (residuo), de −2 a 14). Los residuos de entrenamiento (azul) se reparten alrededor de 0 sin tendencia en todo el rango; los residuos de test (verde) crecen linealmente con X, desde ≈−2 en X=0 hasta ≈13 en X=10.
Pregunta 25 de 50 · N.º original 27 Informática y TIC Analice la siguiente transformación de datos, donde la gráfica de la izquierda presenta los datos originales y la gráfica de la derecha los datos transformados. ¿Qué técnica se ha utilizado?
Dos diagramas de dispersión: a la izquierda, datos originales en una nube alargada en diagonal (correlación positiva, orientada a ~45°); a la derecha, los datos transformados forman una nube alargada horizontalmente, centrada y alineada con los ejes (rotada respecto al original).
Pregunta 26 de 50 · N.º original 28 Informática y TIC Se desea implementar un proceso en Spark para unificar una serie de ficheros texto. El proceso de unificación consiste en crear un único fichero que contenga todas las líneas de los ficheros originales, pero eliminando líneas duplicadas, esto es, aquellas líneas que aparezcan en algún otro lugar, ya sea en el mismo o en diferentes ficheros, de forma que solo quede una única línea de entre todas las copias. Para ello se ha preparado el siguiente script incompleto: Considere también que los ficheros de entrada a cargar tienen el siguiente aspecto (se muestran las 5 primeras líneas de uno de los ficheros) ¿Cuál sería la línea de código faltante?
from pyspark.sql import SparkSession
import shutil
spark = SparkSession.builder.appName("EliminarDuplicados").getOrCreate()
input_fold = "/content/entrada_txt"
output_fold = "/content/resultado"
[FALTANTE]
Asg akag1
12481 8751
Xxxxa AAA nn
Lorem ipsum
En un lugar de la Mancha, de cuyo nombre no quiero acordarme
Pregunta 27 de 50 · N.º original 29 Unión Europea Una empresa situada en Estados Unidos ha creado una app para móviles, abierta a todo el mundo, que permite a sus usuarios mejorar sus hábitos alimenticios. Para ello, los usuarios introducen información sobre lo que van comiendo y la app les ofrece recomendaciones de dieta basadas en modelos de aprendizaje automático. ¿Debe esta app someterse al Reglamento Europeo sobre Inteligencia Artificial (AI Act)?
Pregunta 28 de 50 · N.º original 30 Bases de datos y SQL Se necesita crear una base de datos para gestionar un centro médico, de forma que permita las siguientes operaciones: • Listar los nombres, DNIs y especialidad de todos los médicos del centro. • Identificar a los pacientes por nombre y DNI. • Recuperar la fecha de primer registro en el centro de un paciente. • Consultar para un paciente dado el diagnóstico de las consultas que ha realizado, pudiendo filtrar por médico o tipo de consulta. • Almacenar un listado de medicamentos empleados en el centro, identificados por nombre y código CIE. Indique cuál de los siguientes grupos de sentencias SQL construiría una serie de tablas capaz de satisfacer todos estos requisitos, evitando incluir características innecesarias.
a)
CREATE TABLE Medicos (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    DNI VARCHAR(20) UNIQUE NOT NULL
);
CREATE TABLE Pacientes (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    DNI VARCHAR(20) UNIQUE NOT NULL,
    FechaRegistro DATE NOT NULL
);
CREATE TABLE Consultas (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    TipoConsulta VARCHAR(100) NOT NULL,
    Diagnostico TEXT,
    MedicoID INT NOT NULL,
    PacienteID INT NOT NULL,
    FOREIGN KEY (MedicoID) REFERENCES Medicos(ID),
    FOREIGN KEY (PacienteID) REFERENCES Pacientes(ID)
);
CREATE TABLE Medicamentos (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    CodigoCIE VARCHAR(20) UNIQUE NOT NULL
);
b)
CREATE TABLE Medicos (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    DNI VARCHAR(20) UNIQUE NOT NULL,
    Especialidad VARCHAR(100) NOT NULL
);
CREATE TABLE Pacientes (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    DNI VARCHAR(20) UNIQUE NOT NULL,
    FechaRegistro DATE NOT NULL
);
CREATE TABLE Consultas (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    TipoConsulta VARCHAR(100) NOT NULL,
    Diagnostico TEXT,
    MedicoID VARCHAR(100),
    PacienteID VARCHAR(100)
);
CREATE TABLE Medicamentos (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    CodigoCIE VARCHAR(20) UNIQUE NOT NULL
);
c)
CREATE TABLE Medicos (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    DNI VARCHAR(20) UNIQUE NOT NULL,
    Especialidad VARCHAR(100) NOT NULL
);
CREATE TABLE Pacientes (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    DNI VARCHAR(20) UNIQUE NOT NULL,
    FechaRegistro DATE NOT NULL
);
CREATE TABLE Consultas (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    TipoConsulta VARCHAR(100) NOT NULL,
    Diagnostico TEXT,
    MedicoID INT NOT NULL,
    PacienteID INT NOT NULL,
    Prescripcion INT NOT NULL,
    FOREIGN KEY (MedicoID) REFERENCES Medicos(ID),
    FOREIGN KEY (PacienteID) REFERENCES Pacientes(ID),
    FOREIGN KEY (Prescripcion) REFERENCES Medicamentos(ID)
);
CREATE TABLE Medicamentos (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    CodigoCIE VARCHAR(20) UNIQUE NOT NULL
);
d)
CREATE TABLE Medicos (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    DNI VARCHAR(20) UNIQUE NOT NULL,
    Especialidad VARCHAR(100) NOT NULL
);
CREATE TABLE Pacientes (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    DNI VARCHAR(20) UNIQUE NOT NULL,
    FechaRegistro DATE NOT NULL
);
CREATE TABLE Consultas (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    TipoConsulta VARCHAR(100) NOT NULL,
    Diagnostico TEXT,
    MedicoID INT NOT NULL,
    PacienteID INT NOT NULL,
    FOREIGN KEY (MedicoID) REFERENCES Medicos(ID),
    FOREIGN KEY (PacienteID) REFERENCES Pacientes(ID)
);
CREATE TABLE Medicamentos (
    ID INT AUTO_INCREMENT PRIMARY KEY,
    Nombre VARCHAR(100) NOT NULL,
    CodigoCIE VARCHAR(20) UNIQUE NOT NULL
);
Pregunta 29 de 50 · N.º original 31 Sistemas operativos Considere el siguiente conjunto de datos donde cada color es una clase, representado mediante un diagrama de dispersión (scatter plot). Considere también que va a entrenarse un modelo de tipo Support Vector Machine (SVM) sobre estos datos, para el que debe ajustarse el peso de regularización C, el tipo de kernel K y los parámetros de este. ¿Qué configuración de parámetros de la SVM proporcionaría mejores resultados para este problema de clasificación binaria?
Diagrama de dispersión de dos clases: puntos rojos agrupados en el centro, rodeados por un anillo de puntos azules (clases no separables linealmente, distribución concéntrica).
Pregunta 30 de 50 · N.º original 32 Programación y desarrollo Teniendo en cuenta la siguiente tabla de valores del algoritmo Q-learning, ¿qué acción realizaría a continuación un agente que estuviera en el estado s3 para el siguiente paso de explotación?
Tabla Q-learning:
Q | a1 | a2 | a3
s1 | -1 | 4 | 10
s2 | 3 | -10 | -3
s3 | 7 | 2 | 3
Pregunta 31 de 50 · N.º original 33 Inteligencia artificial y datos Suponga que está usted diseñando una red neuronal artificial para abordar un problema de clasificación con 3 clases excluyentes entre sí, y que cuenta con 10 variables explicativas. Además, se desea que la red devuelva una estimación de las probabilidades de pertenencia a cada una de clases. ¿Qué diseño de red sería más adecuado?
Pregunta 32 de 50 · N.º original 34 Programación y desarrollo El algoritmo Proximal Policy Optimization (PPO) es uno de los métodos más utilizados en sistemas de aprendizaje por refuerzo. Suponga la siguiente notación relacionada con este algoritmo: π_θ la función de política que está siendo entrenada, π_θold una versión anterior de esa política, r_t(θ) = π_θ(a_t|s_t) / π_θold(a_t|s_t) la razón de probabilidades de ambas políticas, A_t la ventaja o “advantage” estimada para el paso t, clip(x, a, b) una función que recorta el valor de x para que esté en el intervalo [a, b], V_θ la función valor, V_target una estimación de lo que debería haberse obtenido por la función valor, (ϵ, c₁, c₂) hiperparámetros a ajustar. Indique cuál de las siguientes expresiones representa correctamente este algoritmo:
Notación: π_θ la función de política que está siendo entrenada; π_θold una versión anterior de esa política; r_t(θ) = π_θ(a_t|s_t) / π_θold(a_t|s_t) la razón de probabilidades de ambas políticas; A_t la ventaja estimada para el paso t; clip(x, a, b) función que recorta x al intervalo [a, b]; V_θ la función valor; V_target estimación de lo que debería haberse obtenido por la función valor; (ϵ, c₁, c₂) hiperparámetros.
a) min_θ E_t[ min(r_t(θ)A_t, clip(r_t(θ), 1−ϵ, 1+ϵ)) − c₁ (V_θ(s_t) − V_target(s_t))² + c₂ entropy[π_θ](s_t) ]
b) max_θ E_t[ min(r_t(θ)A_t, clip(r_t(θ), 1−ϵ, 1+ϵ)A_t) − c₁ (V_θ(s_t) − V_target(s_t))² + c₂ entropy[π_θ](s_t) ]
c) min_θ E_t[ max(r_t(θ)A_t, clip(r_t(θ), 1−ϵ, 1+ϵ)A_t) − c₁ (V_θ(s_t) − V_target(s_t))² + c₂ entropy[π_θ](s_t) ]
d) max_θ E_t[ min(r_t(θ)A_t, clip(r_t(θ), 1−ϵ, 1+ϵ)A_t) − c₁ (V_θ(s_t) − V_target(s_t))² − c₂ entropy[π_ref](s_t) ]
Pregunta 33 de 50 · N.º original 35 Inteligencia artificial y datos Para una aplicación en el sector bancario se necesita construir un modelo supervisado que estime la probabilidad de que un potencial cliente de un préstamo incurra en morosidad. Para ello se cuenta con un conjunto de datos que recopila unas 50 variables derivadas de la información del cliente. Debido a la regulación propia del banco, este modelo debe ser representable como una serie de reglas de fácil explicación. Teniendo en cuenta estas limitaciones, ¿qué modelo sería el más adecuado desde un punto de vista de explicación de su resultado?
Pregunta 34 de 50 · N.º original 36 Informática y TIC Se ha entrenado un modelo usando Extreme Gradiente Boosting (XGB) sobre un dataset cuyas variables explicativas son información clínica de un paciente, y la variable objetivo es si tal paciente va a sufrir complicaciones tras una intervención quirúrgica (clase positiva = complicaciones, clase negativa = sin complicaciones). Para poder conseguir explicabilidad de este modelo se ha generado la siguiente gráfica de dependencias parciales. ¿Cuál de las siguientes conclusiones sería una interpretación válida de esta gráfica?
Gráfica de dependencia parcial (eje X: Age, de ~15 a 90; eje Y: Partial dependence, de ~0.12 a ~0.29): plana en ~0.12 hasta ~22 años, sube con fuerza entre 25 y 40, alcanza el máximo (~0.29) en torno a 50-55, baja entre ~58 y 65 y se estabiliza en ~0.25 a partir de ~70. Marcas de deciles en el eje X.
Pregunta 35 de 50 · N.º original 37 Informática y TIC Tras entrenar un clasificador de tipo Random Forest sobre una serie de datos de entrenamiento observa que en el conjunto de test el error de clasificación es significativamente más alto que en el conjunto de entrenamiento. ¿Cuál sería una medida que contribuiría a reducir este sobreajuste?
Pregunta 36 de 50 · N.º original 38 Inteligencia artificial y datos Se tiene un dataset de 50 variables numéricas, para el cual se desea construir una visualización informativa y de alta densidad sobre las correlaciones cruzadas entre todas ellas. ¿Qué tipo de gráfica sería más adecuada?
Pregunta 37 de 50 · N.º original 39 Informática y TIC ¿Cuál de los siguientes conjuntos de ecuaciones representa correctamente el funcionamiento de una celda LSTM (Long short-term memory) estándar?
a) f_t = tanh(W_f·[h_{t−1}, x_t] + b_f); i_t = σ(W_i·[h_{t−1}, x_t] + b_i); o_t = σ(W_o·[h_{t−1}, x_t] + b_o); c_t = f_t ⊙ c_{t−1} + i_t ⊙ tanh(W_c·[h_{t−1}, x_t] + b_c); h_t = o_t ⊙ tanh(c_t)
b) f_t = σ(W_f·[h_{t−1}, x_t] + b_f); i_t = σ(W_i·[h_{t−1}, x_t] + b_i); o_t = σ(W_o·[h_{t−1}, x_t] + b_o); c_t = f_t ⊙ c_{t−1} + i_t ⊙ tanh(W_c·[h_{t−1}, x_t] + b_c); h_t = o_t ⊙ tanh(c_t)
c) f_t = σ(W_f·[h_{t−1}, x_t] + b_f); i_t = tanh(W_i·[h_{t−1}, x_t] + b_i); o_t = tanh(W_o·[h_{t−1}, x_t] + b_o); c_t = f_t + c_{t−1} + i_t + tanh(W_c·[h_{t−1}, x_t] + b_c); h_t = σ(c_t)
d) f_t = σ(W_f·h_{t−1} + x_t + b_f); i_t = σ(W_i·h_{t−1} + x_t + b_i); o_t = σ(W_o·h_{t−1} + x_t + b_o); c_t = (f_t + i_t) ⊙ tanh(W_c·h_{t−1} + x_t + b_c); h_t = o_t + c_t
Pregunta 38 de 50 · N.º original 40 Informática y TIC ¿Cuál es el principal aporte de Extreme Gradient Boosting (XGB) sobre los métodos de Gradient Boosting estándar?
Pregunta 39 de 50 · N.º original 41 Inteligencia artificial y datos Se le plantea construir un sistema predictivo para una entidad que realiza leasing de automóviles. El modelo debe ser capaz de predecir el valor de venta que tendrá dentro de 4 años un vehículo comprado a fecha de hoy. Además, la entidad necesita también una estimación del riesgo inherente a cada predicción de manera flexible, dando una distribución completa por predicción, de forma que pueda usar esta información para reservar fondos que puedan cubrir posibles pérdidas causadas por errores en la predicción. ¿Qué modelo de machine learning permitiría cumplir estos requisitos?
Pregunta 40 de 50 · N.º original 42 Inteligencia artificial y datos Según la teoría de los ensembles de modelos, ¿cuál de las siguientes configuraciones de ensamblado ofrecería una ventaja sobre emplear únicamente uno de los modelos base? Considere que cada modelo del ensemble se entrena sobre ligeras variaciones del mismo conjunto de entrenamiento.
Pregunta 41 de 50 · N.º original 43 Programación y desarrollo Un agente de aprendizaje por refuerzo está ejecutando el algoritmo DQN (Deep Q-Network). Observa que, aunque al inicio del entrenamiento el agente se comporta de manera muy variada, explorando diferentes formas de actuación y obteniendo algunos resultados muy positivos de forma esporádica, a partir de un momento dado se ancla a un comportamiento subóptimo y no modifica más esta política. ¿Cuál sería la estrategia más adecuada para mejorar este proceso de entrenamiento?
Pregunta 42 de 50 · N.º original 44 Informática y TIC Se ha generado la siguiente gráfica para comparar los resultados de varios modelos de clasificación sobre un problema, incluyendo también una solución básica de referencia (BASELINE). ¿Cómo podría mejorarse esta visualización para presentar la información de manera más clara?
Gráfico de barras «Comparativa de F1 Score entre Modelos de Clasificación» (eje Y: F1 Score de 0 a ~0.9; eje X: Modelos, sin ordenar): Random Forest ≈0.41, SVM ≈0.50, KNN ≈0.80, Logistic Regression ≈0.78, Gradient Boosting ≈0.89, Naive Bayes ≈0.81, Neural Network ≈0.78, AdaBoost ≈0.79, Decision Tree ≈0.41, XGBoost ≈0.82, LightGBM ≈0.86, CatBoost ≈0.83, Extra Trees ≈0.79, Bagging Classifier ≈0.80, Quadratic Discriminant Analysis ≈0.79, Linear Discriminant Analysis ≈0.50, Ridge Classifier ≈0.83, Passive Aggressive ≈0.56, SGD Classifier ≈0.80, Perceptron ≈0.88, BASELINE ≈0.59. Todas las barras del mismo color naranja.
Pregunta 43 de 50 · N.º original 45 Inteligencia artificial y datos Está usted participando en el diseño de un test clínico para una enfermedad pulmonar, el cual se basa en características obtenidas de un análisis de sangre. El test se implementará mediante un modelo de machine learning, el cual deberá determinar la probabilidad de que el paciente analizado esté afectado por la enfermedad, y el objetivo del proyecto es desplegar tal modelo en hospitales de todo el país. Para el entrenamiento del modelo se han recogido muestras de 5 centros diferentes. Un análisis descriptivo de los datos revela que medias y las correlaciones entre las variables son ligeramente diferentes entre los datos recogidos en hospitales diferentes. ¿Cuál sería la estrategia de evaluación más adecuada para el modelo que está creando?
Pregunta 44 de 50 · N.º original 46 Informática y TIC Debe implementar un modelo de clasificación para determinar la probabilidad de que un potencial cliente de una entidad crediticia devuelva un préstamo a tiempo. La tabla de datos disponible para ello es la siguiente (se muestran las 10 primeras filas): ¿Qué modelo sería más adecuado para esta tarea?
Cliente previo,Alto importe,Estudios,Nivel salarial,Ocupación,Aval,Devolución
True,True,Primaria,Medio,Empleado,Personal,True
False,False,Primaria,Medio,Empresario,Hipotecario,True
False,False,Universitario,Bajo,Autónomo,Sin aval,False
True,False,Primaria,Medio,Empleado,Personal,True
True,False,Primaria,Medio,Empleado,Sin aval,True
True,False,Universitario,Alto,Empleado,Personal,False
True,False,Secundaria,Alto,Empleado,Hipotecario,True
False,False,Universitario,Bajo,Empleado,Sin aval,True
True,True,Primaria,Medio,Autónomo,Personal,True
Pregunta 45 de 50 · N.º original 47 Informática y TIC En un problema de clasificación multiclase ha obtenido la siguiente matriz de confusión: ¿Cuál es el F1-score macro averaged?
Matriz de confusión (filas = real, columnas = predicción):
 | Pred A | Pred B | Pred C
Real A | 20 | 0 | 0
Real B | 0 | 20 | 0
Real C | 0 | 20 | 20
Pregunta 46 de 50 · N.º original 48 Inteligencia artificial y datos Indique qué algoritmo de optimización, de tipo gradiente estocástico, está basado en el ajuste dinámico de los momentos estadísticos de distintos órdenes para actualizar los pesos en redes neuronales:
Pregunta 47 de 50 · N.º original 49 Inteligencia artificial y datos Se plantea resolver un problema de NER (Named Entity Recognition) sobre documentos de varios cientos de palabras, empleando para ello una arquitectura de red neuronal recurrente. ¿Qué configuración de capas sería más adecuada, considerando que no deben añadirse características innecesarias?
Pregunta 48 de 50 · N.º original 50 Sistemas operativos Necesita crear un modelo para un dataset de gran tamaño, del orden de millones de datos de entrenamiento con decenas de miles de variables. ¿Cuál de los siguientes modelos y algoritmos sería el más eficiente en tiempo de entrenamiento para esta situación?
Pregunta 49 de 50 · Reserva original 51 Informática y TIC En una competición de Kaggle ha participado en un equipo con varias personas, cada una de ellas creando un modelo diferente para afrontar el problema. Tras realizar varios experimentos, llegan a la conclusión de que los mejores resultados en validación se alcanzan creando un modelo de tipo XGB que se alimente de las predicciones de cada uno de los modelos individuales. ¿Qué técnica describe mejor el proceso empleado aquí?
Pregunta 50 de 50 · Reserva original 52 Inteligencia artificial y datos Suponga que cuenta con datos en el siguiente formato: ¿Qué modelo de machine learning se ajusta más a la implementación de la siguiente línea de código?
X = np.array([
    [1, 2],
    [2, 0],
    [3, 1],
    [4, 3],
    [5, 5]
])
y = np.array([2, 1, 2, 3, 5])
lambda = 10
beta = np.linalg.inv(X.T @ X + lambda * np.eye(2)) @ X.T @ y

Preguntas anuladas por el tribunal

Ver todas las anuladas

El tribunal anuló 2 preguntas de este examen. No se incluyen en el test ni cuentan para la nota. Se muestra el motivo de la anulación.

  1. Pregunta original 8. Se encuentra usted desarrollando un modelo de aprendizaje supervisado para predecir impagos en préstamos bancarios. Analice la siguiente muestra de datos que tiene disponible, e indique si debe tener en cuenta alguna consideración legal o ética respecto al uso de estos datos:
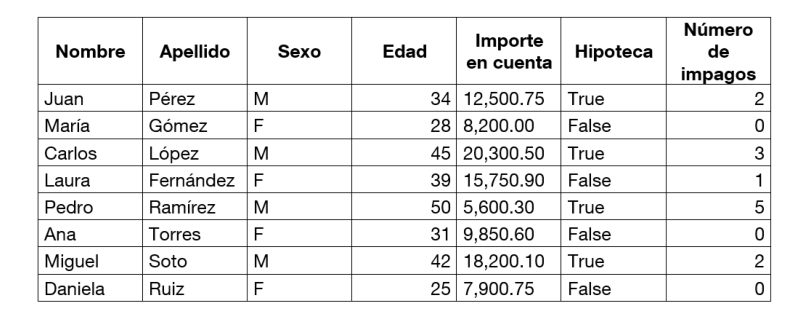
    Tabla de datos con columnas Nombre, Apellido, Sexo, Edad, Importe en cuenta, Hipoteca, Número de impagos:
Juan | Pérez | M | 34 | 12,500.75 | True | 2
María | Gómez | F | 28 | 8,200.00 | False | 0
Carlos | López | M | 45 | 20,300.50 | True | 3
Laura | Fernández | F | 39 | 15,750.90 | False | 1
Pedro | Ramírez | M | 50 | 5,600.30 | True | 5
Ana | Torres | F | 31 | 9,850.60 | False | 0
Miguel | Soto | M | 42 | 18,200.10 | True | 2
Daniela | Ruiz | F | 25 | 7,900.75 | False | 0

    Protección de Datos Personales (RGPD UE 2016/679 y LOPDGDD – LO 3/2018)

    • a) Según el reglamento europeo de la IA, no es legal implementar un sistema de IA que realice perfilado de personas, y dado que este sistema está orientado a detectar perfiles de riesgo de impago, no sería legal.
    • b) Los campos Sexo y Edad deberían eliminarse de la tabla de datos a la hora de entrenar el modelo, para mitigar así que el modelo pueda tomar decisiones en base a estos datos personales.
    • c) La tabla no debería contener información personal como el Nombre y el Apellido, ya que el Reglamento General de Protección de Datos prohíbe mantener esta información.
    • d) No se dispone de suficientes variables explicativas como para realizar un modelo con suficiente precisión, lo cual resultaría en un perjuicio injusto para los clientes del banco.

    Motivo de la anulación: Anulada por el tribunal al estimar las alegaciones (sesión de 24/07/2025); la sustituye la reserva 51.

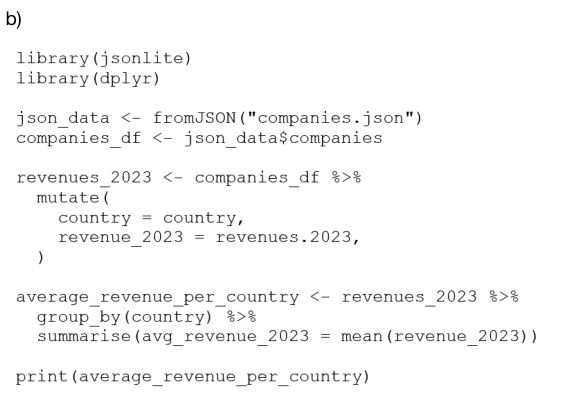
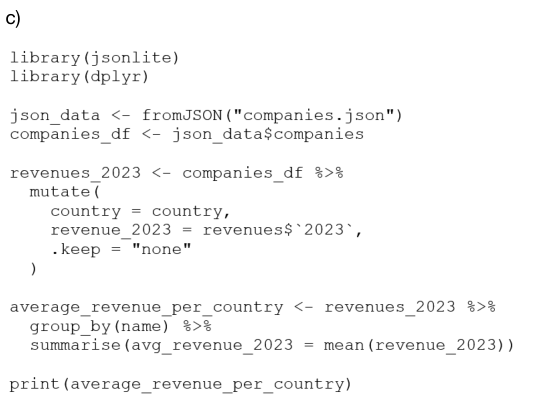
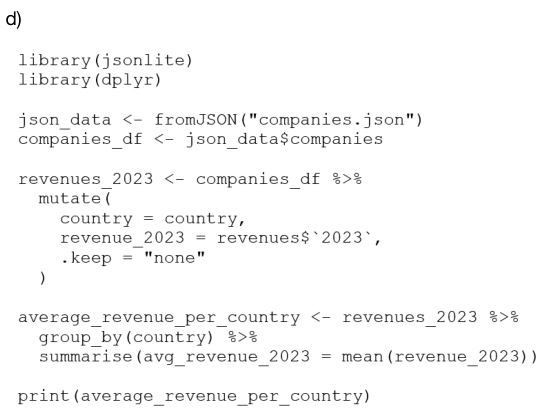
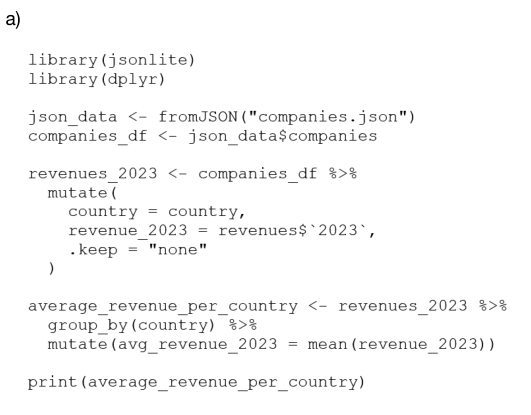
  2. Pregunta original 13. Analice el siguiente fichero "companies.json", del cual se muestran las primeras líneas: ¿Cuál de los siguientes scripts en R calcula correctamente la media de ganancias de las compañías de cada país?
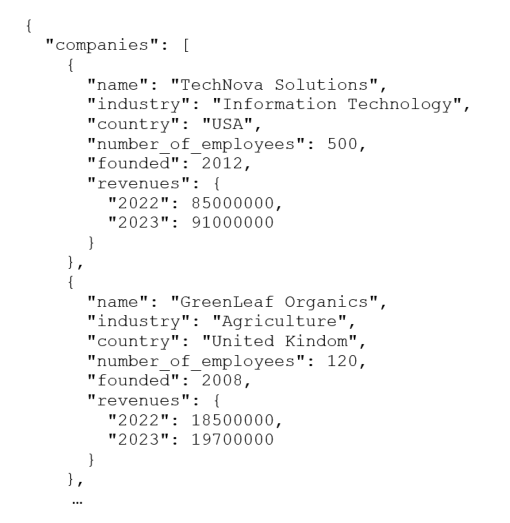
    {
  "companies": [
    {
      "name": "TechNova Solutions",
      "industry": "Information Technology",
      "country": "USA",
      "number_of_employees": 500,
      "founded": 2012,
      "revenues": {
        "2022": 85000000,
        "2023": 91000000
      }
    },
    {
      "name": "GreenLeaf Organics",
      "industry": "Agriculture",
      "country": "United Kindom",
      "number_of_employees": 120,
      "founded": 2008,
      "revenues": {
        "2022": 18500000,
        "2023": 19700000
      }
    },
    …
    a)
library(jsonlite)
library(dplyr)

json_data <- fromJSON("companies.json")
companies_df <- json_data$companies

revenues_2023 <- companies_df %>%
  mutate(
    country = country,
    revenue_2023 = revenues$`2023`,
    .keep = "none"
  )

average_revenue_per_country <- revenues_2023 %>%
  group_by(country) %>%
  mutate(avg_revenue_2023 = mean(revenue_2023))

print(average_revenue_per_country)
    b)
library(jsonlite)
library(dplyr)

json_data <- fromJSON("companies.json")
companies_df <- json_data$companies

revenues_2023 <- companies_df %>%
  mutate(
    country = country,
    revenue_2023 = revenues.2023,
  )

average_revenue_per_country <- revenues_2023 %>%
  group_by(country) %>%
  summarise(avg_revenue_2023 = mean(revenue_2023))

print(average_revenue_per_country)
    c)
library(jsonlite)
library(dplyr)

json_data <- fromJSON("companies.json")
companies_df <- json_data$companies

revenues_2023 <- companies_df %>%
  mutate(
    country = country,
    revenue_2023 = revenues$`2023`,
    .keep = "none"
  )

average_revenue_per_country <- revenues_2023 %>%
  group_by(name) %>%
  summarise(avg_revenue_2023 = mean(revenue_2023))

print(average_revenue_per_country)
    d)
library(jsonlite)
library(dplyr)

json_data <- fromJSON("companies.json")
companies_df <- json_data$companies

revenues_2023 <- companies_df %>%
  mutate(
    country = country,
    revenue_2023 = revenues$`2023`,
    .keep = "none"
  )

average_revenue_per_country <- revenues_2023 %>%
  group_by(country) %>%
  summarise(avg_revenue_2023 = mean(revenue_2023))

print(average_revenue_per_country)

    Internet y web

    • a) La opción a) de la imagen
    • b) La opción b) de la imagen
    • c) La opción c) de la imagen
    • d) La opción d) de la imagen

    Motivo de la anulación: Anulada por el tribunal al estimar las alegaciones (sesión de 24/07/2025); la sustituye la reserva 52.

Fuentes oficiales

Cuestionario oficial (SHA-256 7716b8dcbec36241…) y plantilla de respuestas (SHA-256 033d75e9ed2ebd51…) publicados por el organismo. Plantilla de corrección (24/07/2025): anuladas 8 y 13 (reservas 51 y 52). Fórmulas, código y gráficos como imagen.

Más exámenes de Técnico/a Superior de Sistemas de Información

Ver todos